AI入门第三课——接入 Agent
相信大家从上节课已经尝试过通过调用 API Key 来使用 Cherry Studio 与 RikkaHub 了。没错,你现在已经有了自己的专属豆包——更聪明、更严谨、记忆力更强。
但是这就结束了吗?没有的!这就是为什么出现了豆包专业版(一个月大几百块呢)——能帮你处理表格,帮你做 PPT,帮你画图,甚至帮你操纵电脑!
这是为什么?AI 就是个脑子,我们接入客户端这张嘴以后,怎么就能给我们处理表格了呢?这里要引入一个新的概念——Agent。
什么是 Agent?
Agent 是什么?简单来说,Agent 是一个人:他有自己的嘴巴,有自己的脑子,但最重要的——他有自己的四肢。
- 健全的人 = 脑子 + 嘴 + 身体,于是他就能干活了
- 我们之前的 Cherry Studio 是 脑子(大模型)+ 嘴(客户端),他没有四肢!
于是我们要想办法加入四肢,加入四肢他就自己动手做 PPT、动手画图了!
Agent = 大模型(脑子)+ Harness(四肢和嘴)
这个 Harness 就是给他安装的四肢和嘴巴。你可以这么看:
- Codex = GPT 大模型 + 调用这些大模型的工具
- Claude Code = Claude 大模型 + 调用这些大模型的工具
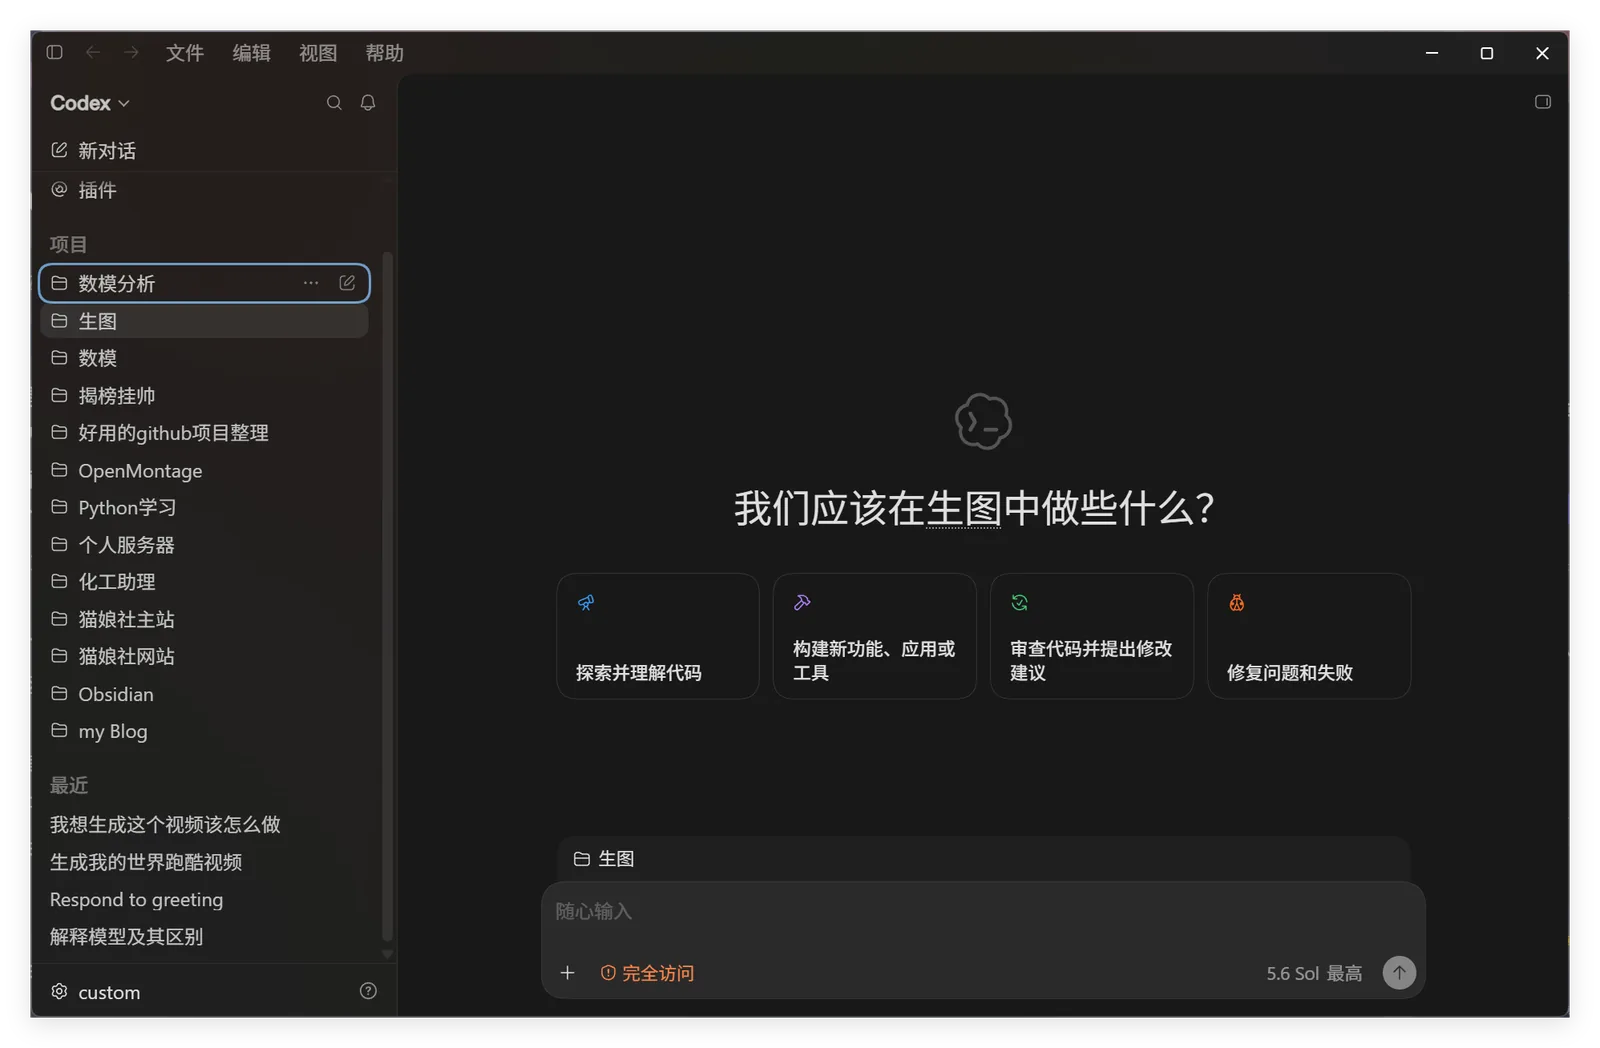
这些工具可以让 Agent 动手干活儿、做 PPT,而大模型就负责告诉这些工具怎么干活儿就行了(这么理解就好,没影响)。
所以你只要拿到了大模型,接入到 Harness 这个大工具里,就有了自己的 Agent(比如之前爆火的 DeepSeek Harness / DSH 就是 Harness,你接入 DeepSeek 或者别的大模型以后就变成了 Agent!)。
补充:我在这里必须澄清,虽然大模型接入 Harness 就是 Agent,但是也是有高下之分的。比如 Kimi 大模型的架构比较适配他们自己公司的 Harness,所以在这里调用的话就会显得很聪明,因为 Kimi 大模型这个脑子发现他使用工具得心应手!拿到专武了!
但是!但是!但是!
有些模型就是不太适配某些 Harness。比如把一个人扔到国外,他是很难和别人交流的,因为他的语言不通,不是母语就容易出现障碍!
所以不要再把 DeepSeek 接入 Codex 了!Codex 不是最好的 Harness,DeepSeek 也不是最好的模型。Codex 火是因为 GPT 是世界前沿模型,加上 Codex 完全针对 GPT,所以效果很好;但是 Codex 的 Harness 具有臃肿、不适配其他模型的缺点!(喜欢我的雷霆报错吗?)
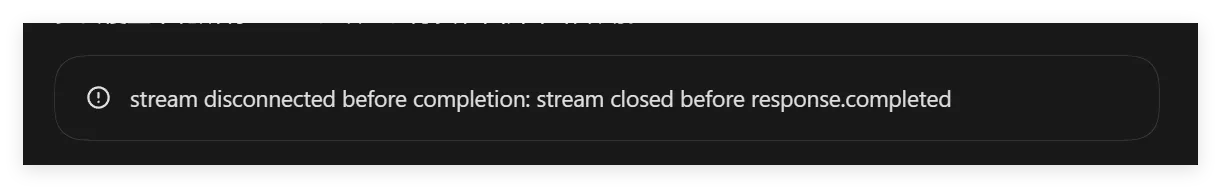
如果你用的不是 GPT 模型,那就不要接入 Codex!
什么模型适合什么 Harness,我这里推荐一些:
| 模型 | 推荐 Harness |
|---|---|
| GPT | 无脑 Codex,且仅适合 Codex |
| Claude Opus / Sonnet | 无脑 Claude Code |
| DeepSeek | 建议 DeepSeek Harness(也就是 DSH),也可以 ZCode |
| GLM | 无脑 ZCode |
| Kimi | 建议 Kimi Code,也可以 ZCode |
| Grok | 建议 Grok Build 或 Cursor,也可以 ZCode |
| Gemini | 爱用啥用啥 |
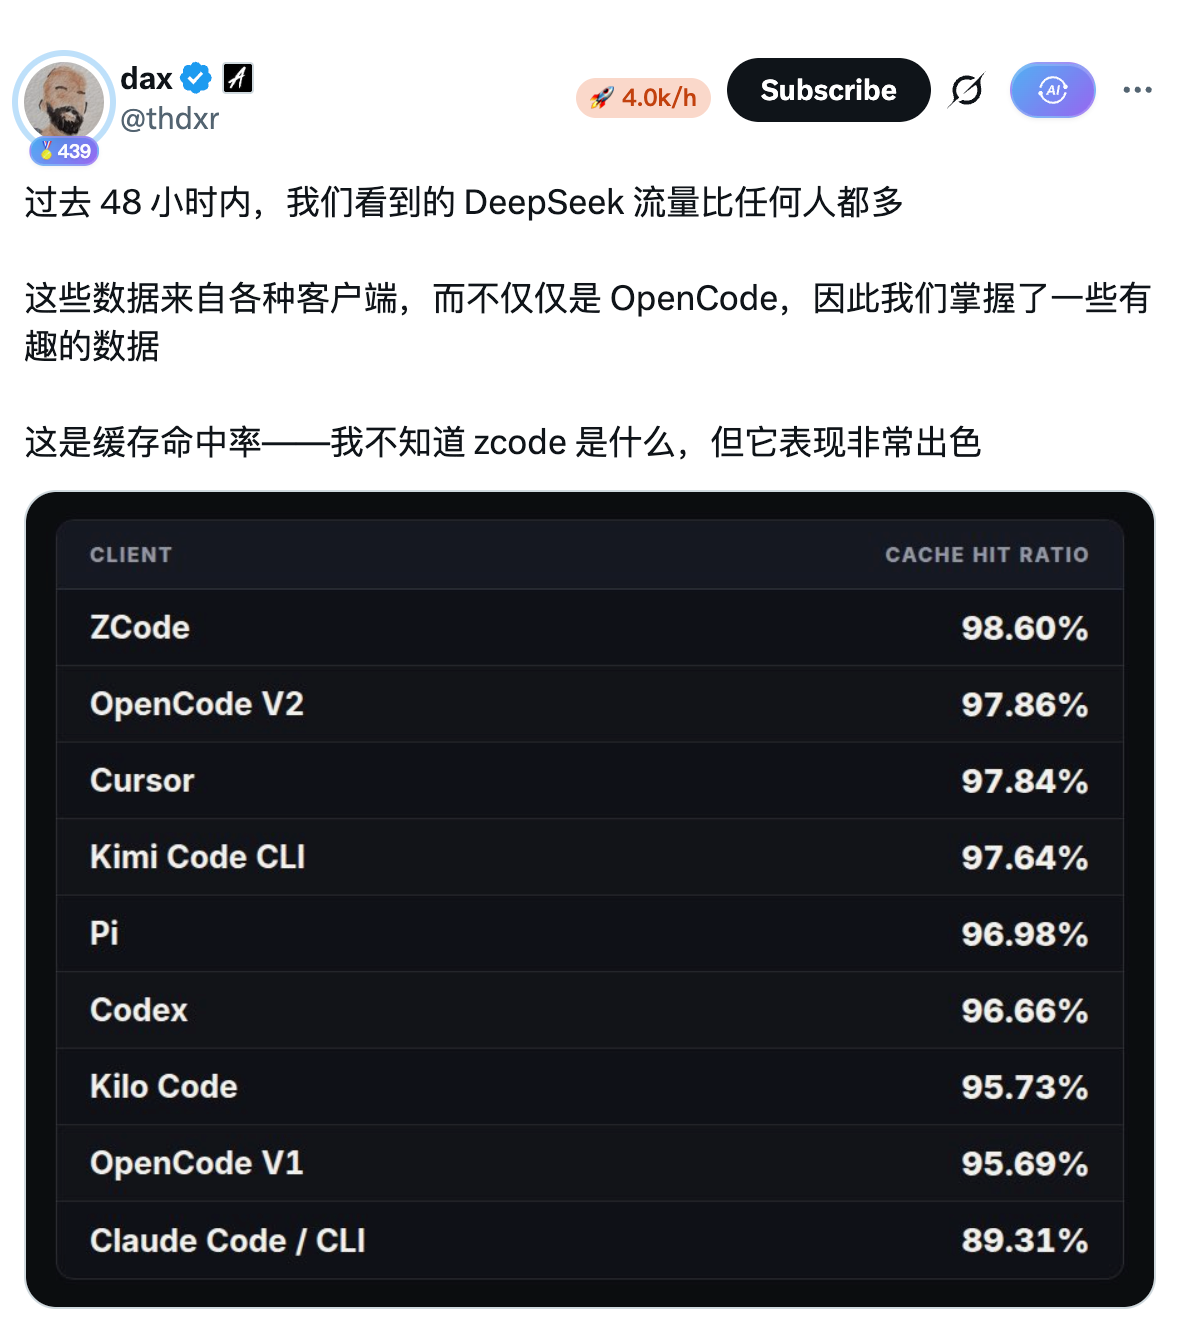
看了这么多专武,我体验下来的结论是:大模型大多有自己的 Harness,个人建议使用它们特定的 Harness。不过下载太多 Harness 对你的 C 盘不太友好,所以国模我建议 ZCode——最适配 GLM,又适配 Kimi,甚至适配 Grok。
声明:不是广告,我喜欢 ZCode,确实好用。
ZCode——我常用的 Harness
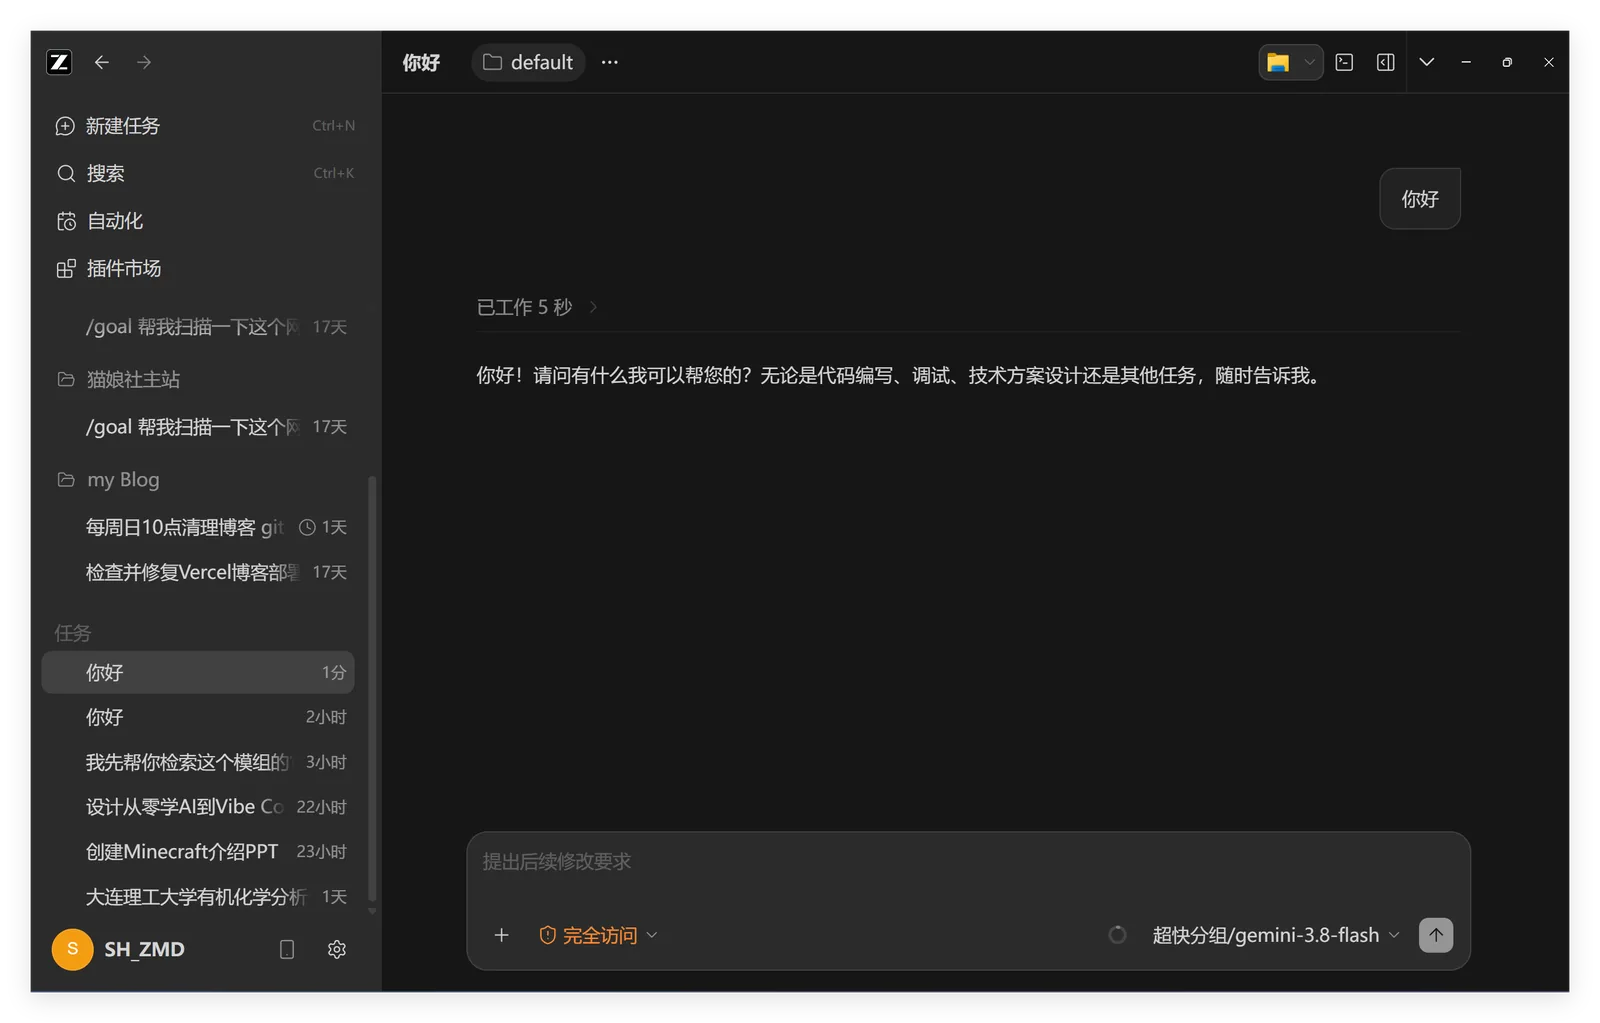
讲了这么多其实都没太大实际作用,我们实际上将大模型接入一个 Harness,让它变成 Agent 就行了!于是这期我们介绍 ZCode——我体验到的一个接入国模甚至部分国外模型都很不错的 Harness。
ZCode 好在哪里?
- 工作比较透明——做了什么,网页在操作什么一眼能看出来;
- 调用工具舒服——想开网页就开网页,不会被各种奇奇怪怪的协议束缚;
- 速度快——我也不知道为什么,但是速度快,又快又好。
对的,相比起你们,GPT 和 Codex,你们无情的抛弃了我😭(OpenAI 又发疯降智了),是 ZCode 稳稳接住了我😭
教程
1. 下载 ZCode 并接入 API Key
依旧设置 - 模型设置 - 添加新模型供应商。
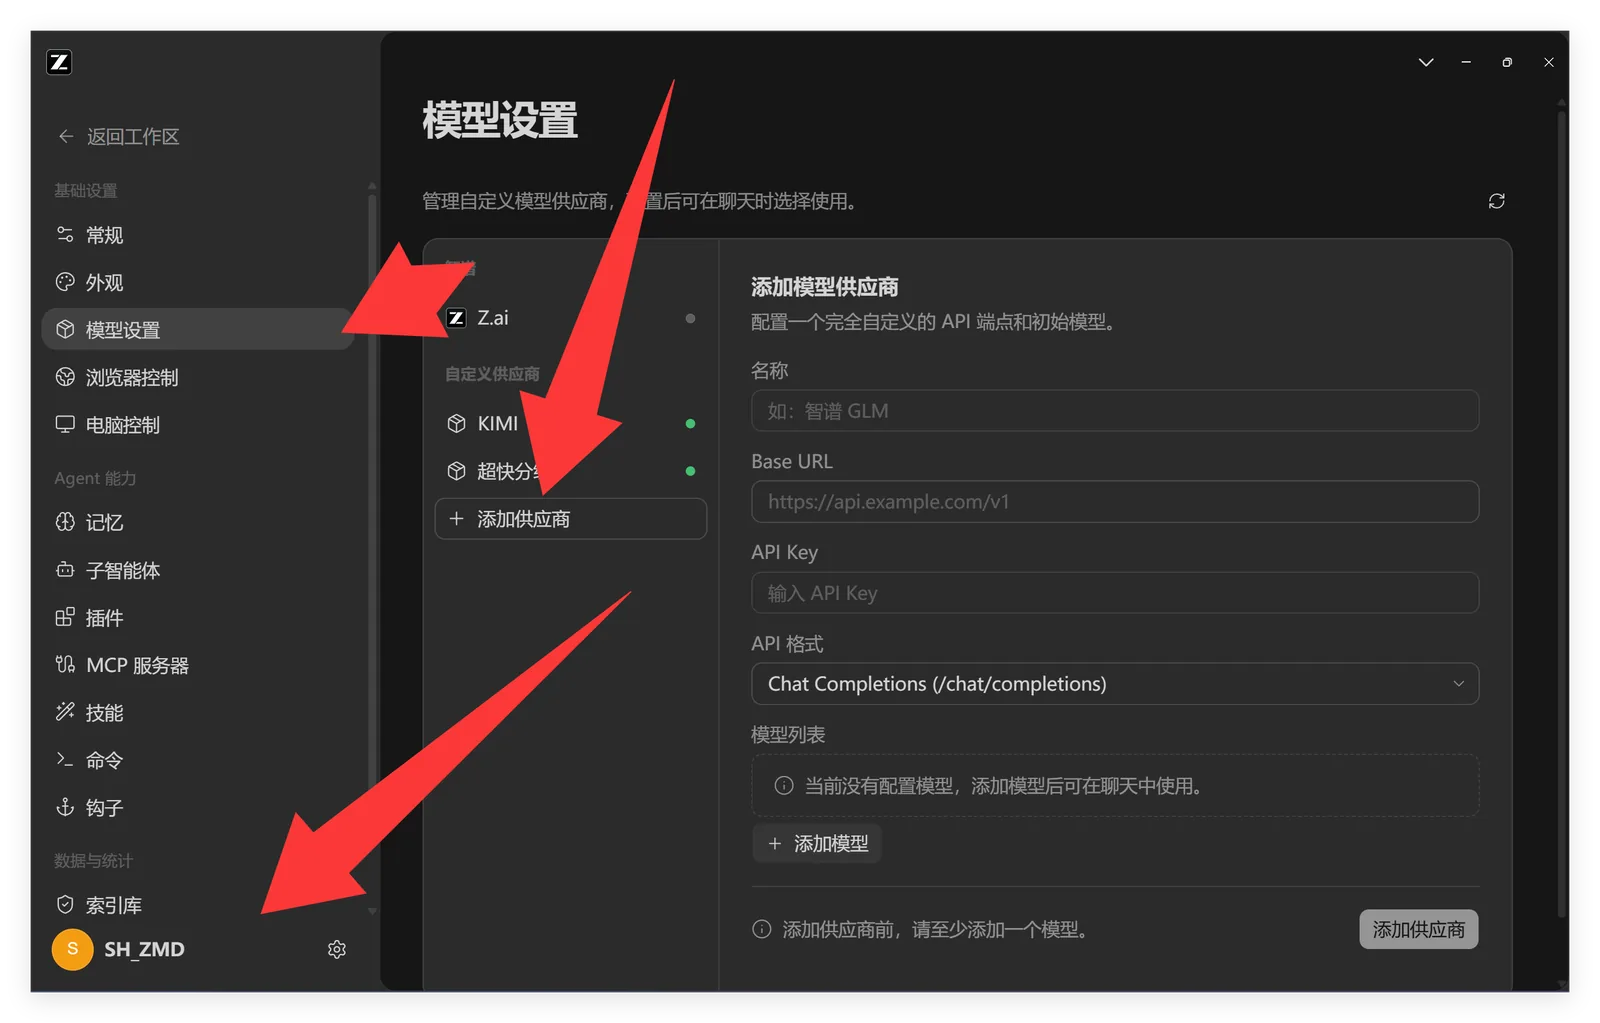
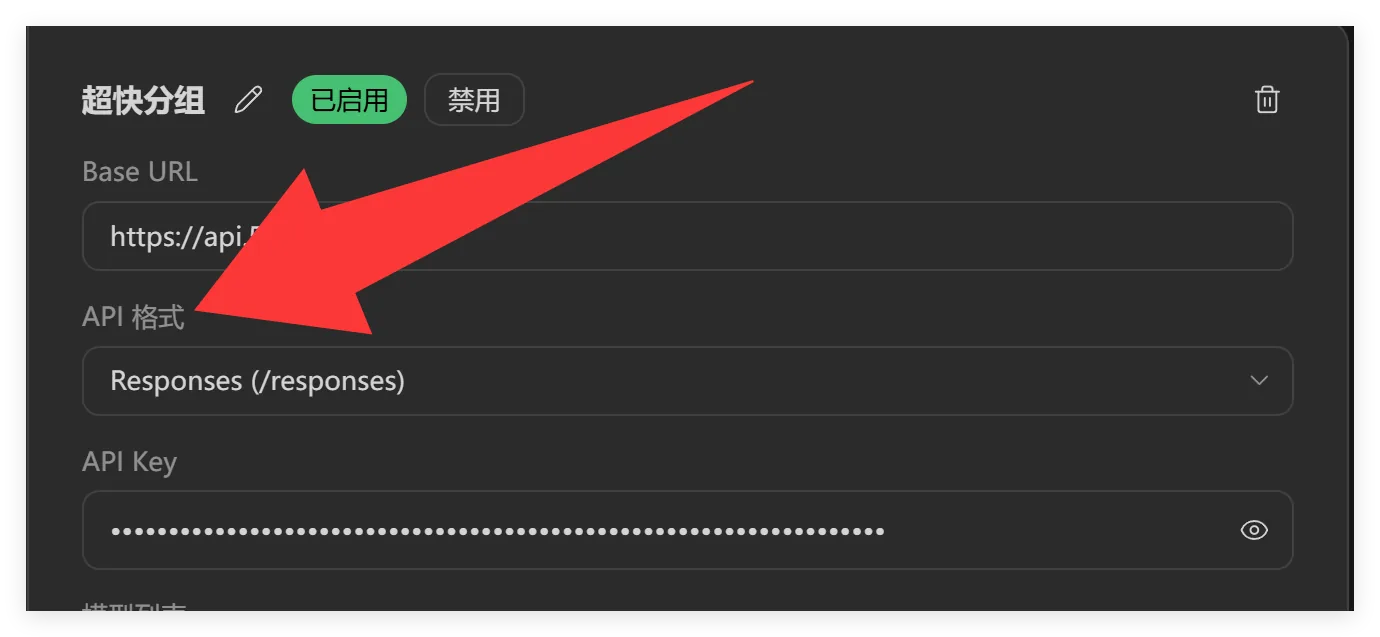
注意:API Key 填入、URL 填入,名字随便。API 格式可能是 chat,可能是 response(但大概率不会是 anthropic,因为只有 Claude 模型才用这个接口),主要还是跟你用的什么模型和上游怎么设置的有关,两个各试一遍就好。
就是这个 API 格式,千万不要用默认的 Anthropic!换 chat 接口试试!不行就用 response!
2. 填入模型
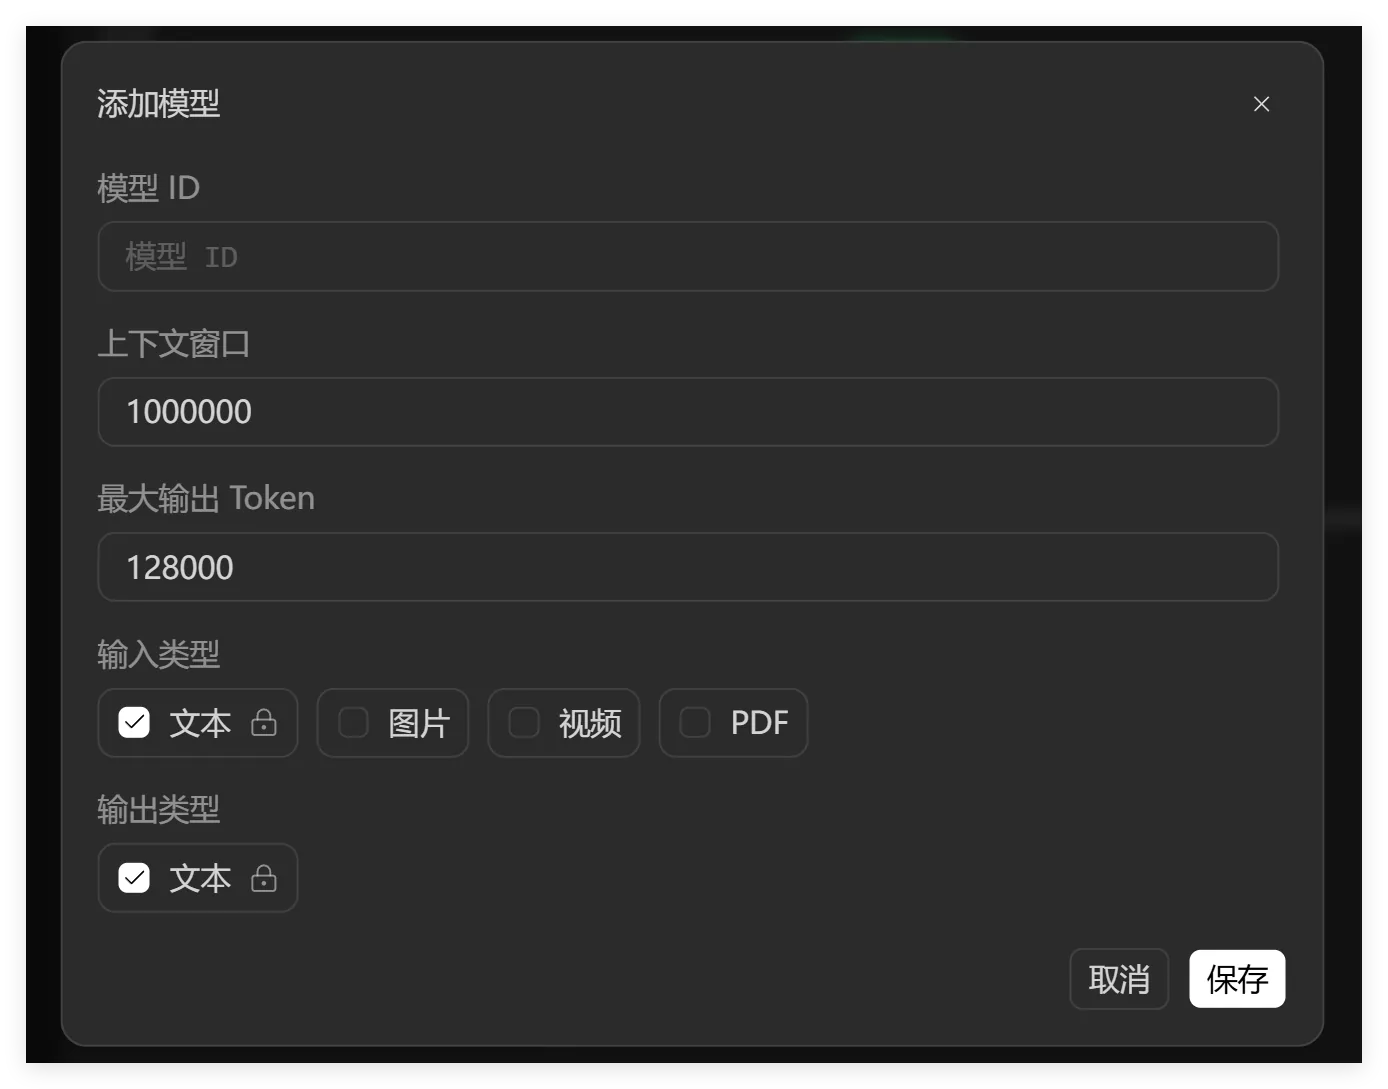
注意:这里一定不要填错!名字和你的上游的模型名称一定要完全一样!
比如你用的 deepseek-v4-flash,那就写 deepseek-v4-flash;如果上游是中转站,模型又叫 deepseek-v4-flash-0731,你就要写 deepseek-v4-flash-0731。至于上游叫什么名称,在你的中转站的模型广场应该都写了。
这里能力也要注意:
- 上下文是模型的记忆能力。你多写不会多记忆,少写就会少记忆,但是写太大也不好,容易让模型造成误判(应该吧);
- 输入类型是他能看什么(文本就是他看得懂字,图片就是他看得懂图片,pdf 就是看得懂图片);
- 输出类型就是他能告诉你什么,文本就是他用文字回复你。
注意:目前 DeepSeek、GLM、Qwen 是瞎子!没有输入图片的能力!试验版本的 vision 模型才有!
这里防止小白不知道填什么,我给大家一些参考(注意:1M 就是一百万上下文 1000000,128k 就是 128000)。
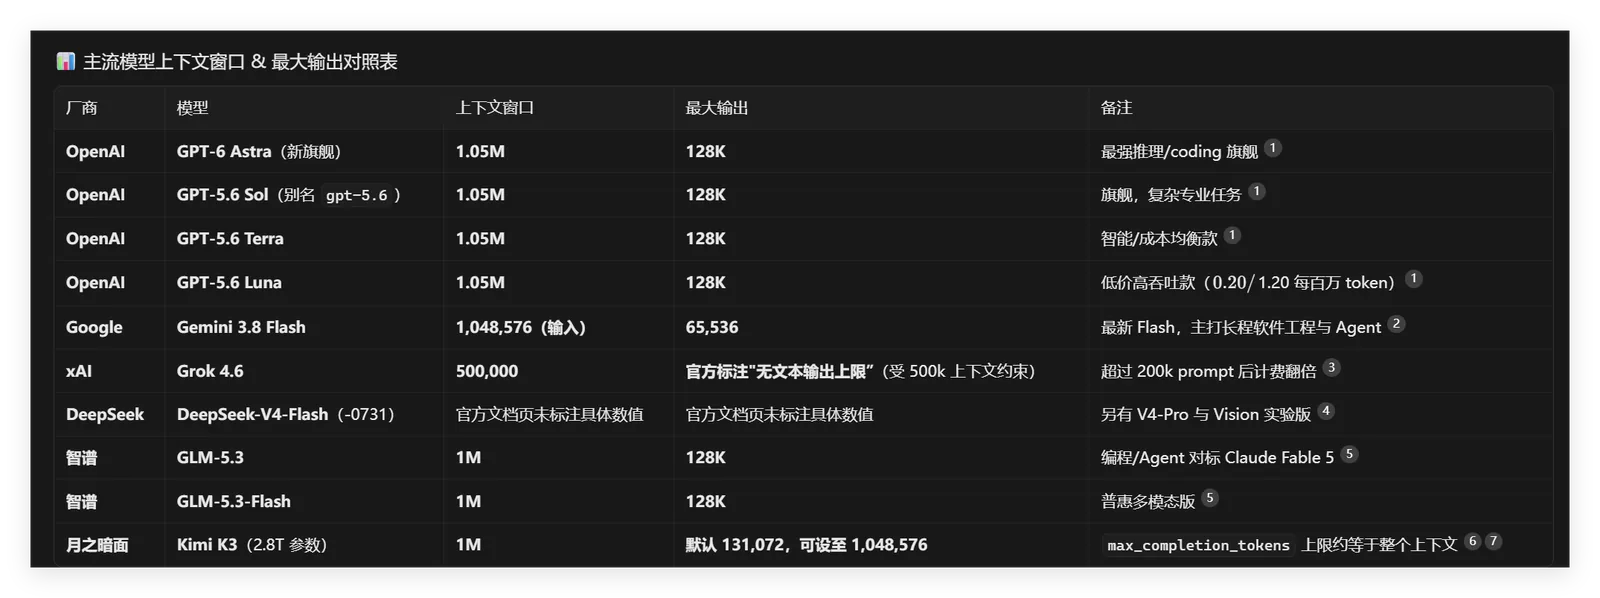
如图,如今大部分模型上下文都是 1M,你也直接写 1000000 就行,差个几万差不了多少。这里尤其注意 Grok 是 500k,不要多写了。
3. 到主页调用
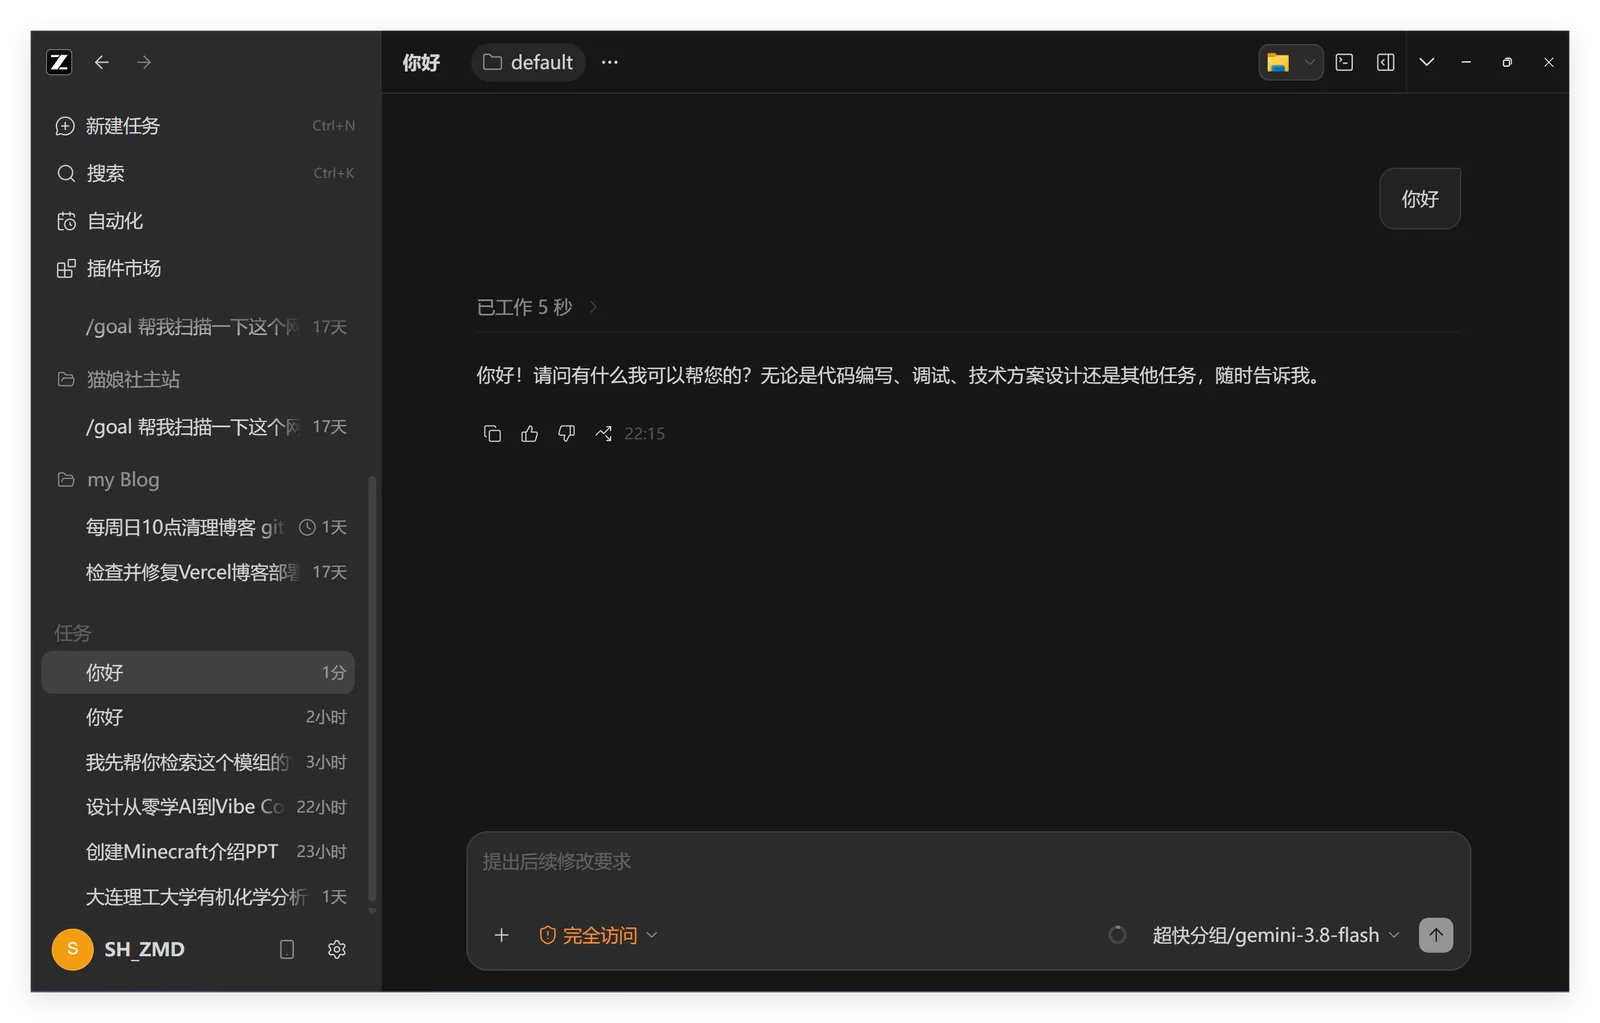
恭喜你,你已经入门 Agent 了!接下来,你可以让他工作了:让他做个 PPT,让他写个程序之类的,直接说就好!
小广告
写这期 blog 的时候我其实也在用中转站的 kimi-k3 对我的 blog 进行修复,很多 gpt-5.5 时代的 bug 一下子就修好了。kimi-k3 强,ZCode 也强。但是原价的 kimi-k3 实在太贵了,完全用不起!😭所以我使用了中转站(使用特殊方法从特殊渠道获取的模型)。
声明:中转站的水很深,不建议任何人无脑使用中转站!也不要充太多钱!
使用中转站会面临信息泄露和掺水(卖给你低级模型,但却标注高级模型),甚至往里面注入病毒的情况!
但这个时候我用的 kimi-k3 确实不错,至少比别的站的 k3 用着更聪明。
声明:站长是我的一个朋友(比较好的网友,送了我很多 token)。所以在这里分享一下他的站点(不过没必要为了我的面子注册这个!你注册这个我没有什么收益!单纯是帮朋友推荐!不要充太多!)
注意:再次提醒——不要往中转站充太多钱!不要无脑使用来源不明的中转站!
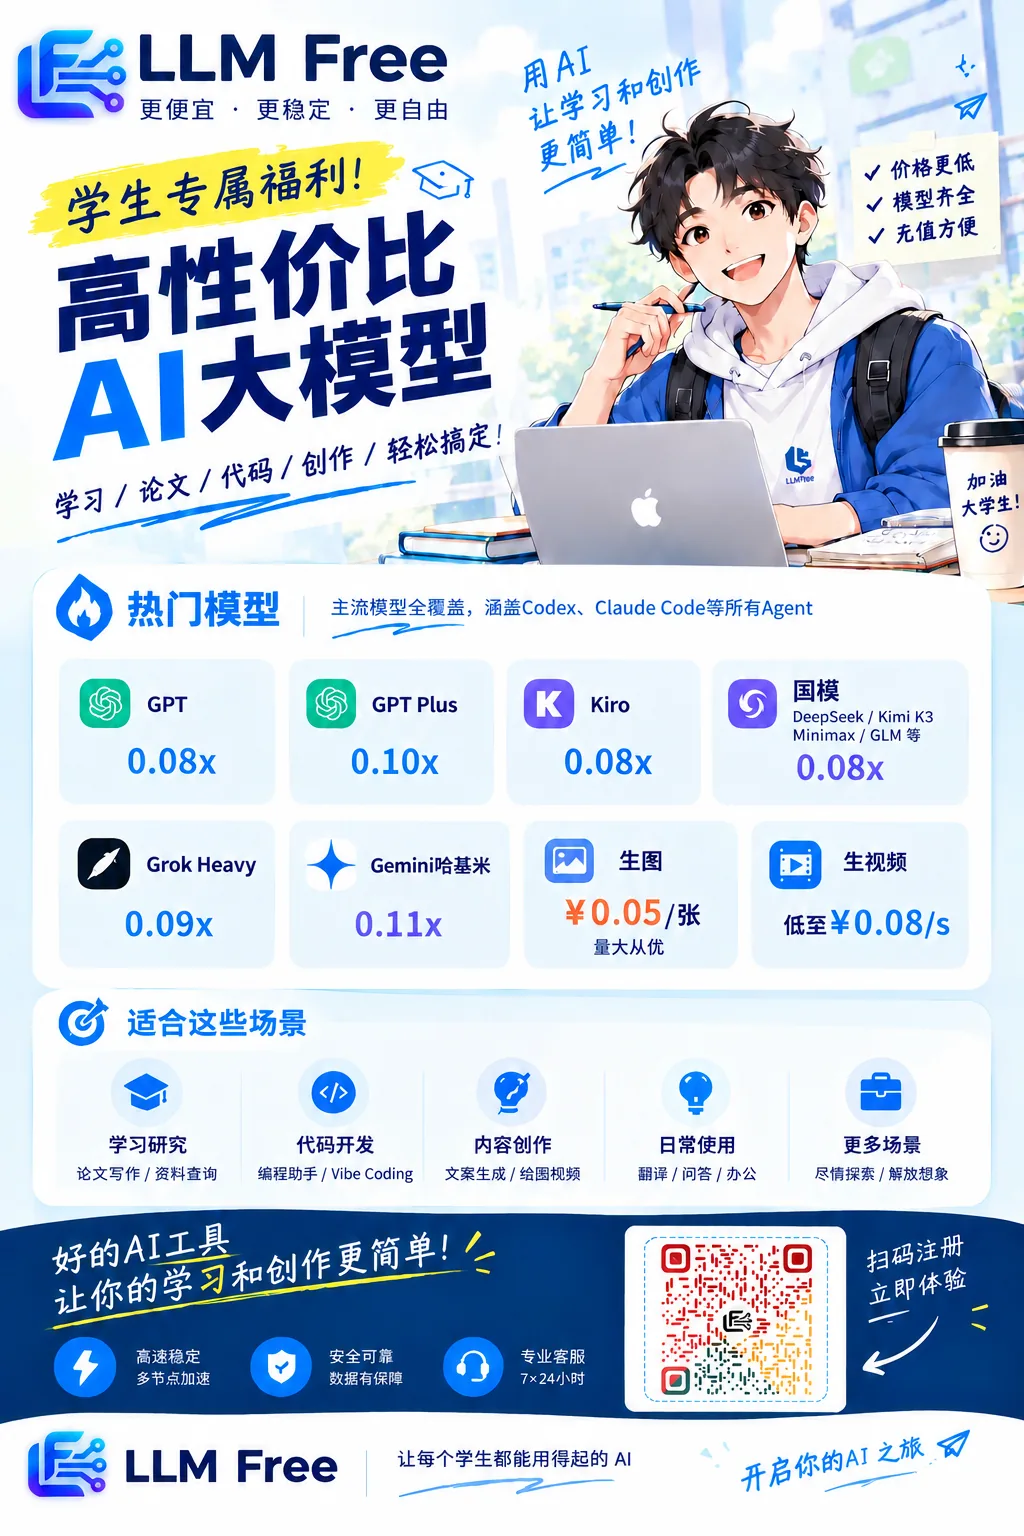
这个站挺不错的,0.08 倍率的国模真的很少见。这是我一句话让 kimi-k3 生成 PPT 的效果:10 页花了 200w token,大概 4~5 毛钱;图片他自己找的,效果自己做的,我只告诉他一句话——做个我的世界介绍 PPT,有时间线贯穿。
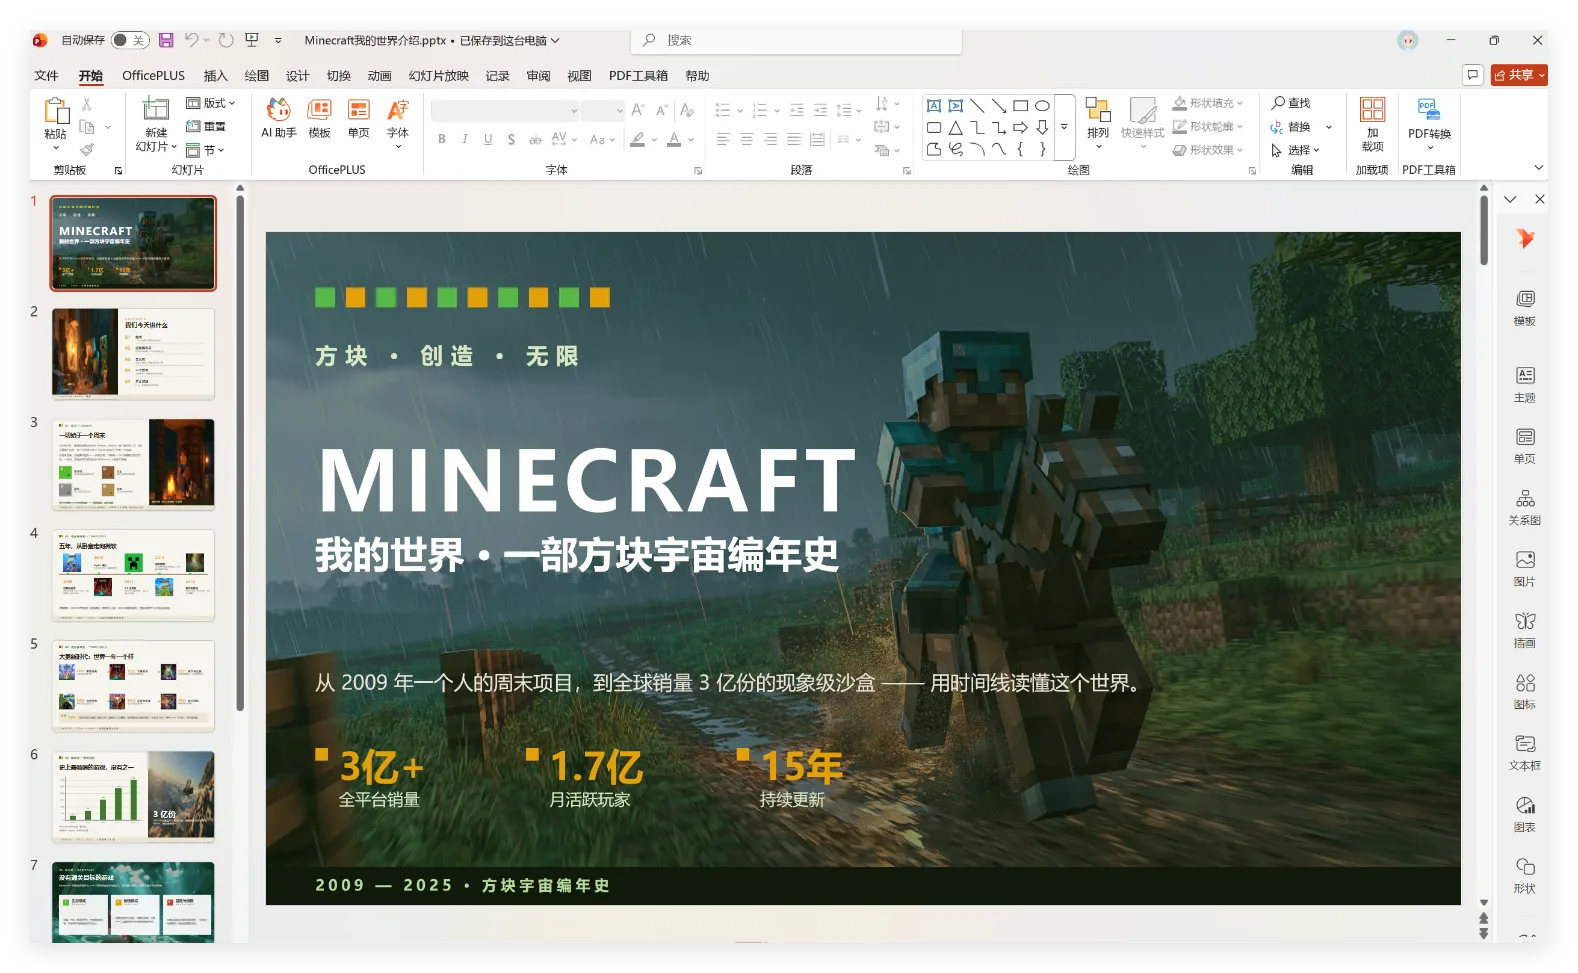
k3 是真强哇(
总之需要的话可以试试,模型能力真的不错,价格也很低。看这效果模型挺纯,是我用过很不错很不错的站点了(只针对国模,GPT 最近抽风,我还没试过)。
声明:再次声明!不要使用来源不明的中转站!不要充太多钱!用几块充几块!也不要为了我注册这个站!我推荐只是因为体验还不错,和站长送了我一些 token!现在很好用,但我没办法保证下周还这么好用!如果这个站变坏了,我会立马删掉!
MESSAGE BOARD
评论区
不用登录,填昵称就能评论;图片会作为附件保存,邮箱和网站不会公开展示。